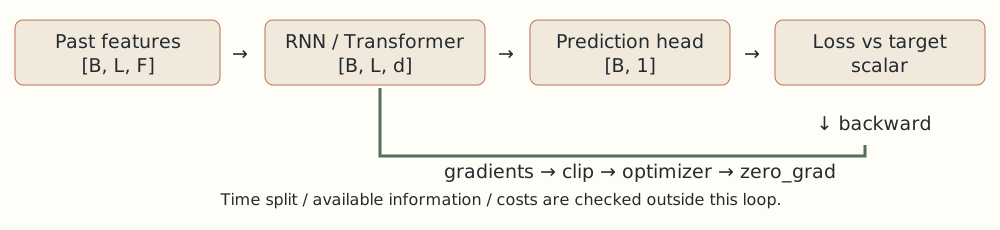
复习路线与知识盘点
本书服务于量化研究、机器学习研究和开发岗位的笔试面试。学习顺序是先把一次预测与一次参数更新手算清楚,再学如何记住历史,最后学如何从历史中选择信息。这里的“核心”表示依赖与迁移价值,不是未经统计的公司出题频率。
- ★ 核心必会:输入输出形状、链式法则、损失与梯度、SGD/Adam/AdamW、RNN状态、LSTM门、QKV注意力、因果掩码和时间泄漏。
- 研究岗重点:BPTT、梯度裁剪、位置编码、pre-LN残差、学习率调度、损失与业务指标、对照实验。
- 进阶专题:MoE稀疏路由、MTP监督与推测解码、Looped Transformer深度共享,见新增专题;RoPE、KV cache和混合精度配合学习。FlashAttention与MLA在机制地图中辨析,SSM和分布式训练未作完整讲解。
第一轮要求能画架构并标维度;第二轮能手推两个时间步和两次优化更新;第三轮遮住代码,独立实现并解释一个失败案例。每节末尾自测先自己做,熟悉题目不等于能解决新题。
从一段行情到一个预测:符号与形状
★ 核心必会。假设每天收盘后用最近三天的两个特征,预测下一天收益。两个特征可为当日收益与成交量变化;这是教学设定,不保证有预测价值。一条样本是三行两列表,行表示时间,列表示特征。将两条这样的样本装在一起,输入形状为 \(B\times L\times F=2\times3\times2\):B是同批样本数,L是历史长度,F是每个时点的特征数。
例如第一条样本为 \(X_1=[(1,2),(0,1),(2,0)]\),数字已作教学缩放。若预测一项收益,标签形状是 \(B\times1\),不是每个时间步都有一个未来可用的答案。历史特征通常先经过一层线性映射:输入行 \(x\) 与矩阵 \(W\in\mathbb R^{F\times d}\) 相乘再加偏置,输出维度d,称为隐藏维度。
第一列为 \(1\times1+2\times0=1\),第二列为2,第三列为 \(1-2+1=0\)。整批映射后是 \(2\times3\times3\)。RNN沿时间行更新状态;Transformer让时间行之间通过注意力交换信息;最后的预测头把选定状态从d维映射成一个数。
易错点:batch轴不是时间轴;张量转置只改变排列,不改变哪些信息在预测时可用。训练样本 \((t-2,t-1,t)\) 的标签若用 \((t,t+1]\) 收益,就不能把t+1的成交量放进输入。自测:B=8,L=20,F=5,d=16,线性映射后的形状?答案:8×20×16,权重5×16,偏置16。
目标与泛化:训练分数在惩罚什么
★ 核心必会。回归可用平均平方误差:先逐样本计算预测减真实,再平方后平均。两条真实收益为(1,−1),预测为(0.5,0),误差为(−0.5,1),MSE为 \((0.25+1)/2=0.625\)。对预测的导数为 \(2(\widehat y_i-y_i)/B\),本例分别−0.5和1。负导数意味着应把该预测提高,正导数意味着应降低。
平方损失最优目标是条件均值,绝对误差对应条件中位数;这两种目标不同。Huber损失在小误差时像平方、大误差时像绝对值,用于降低单个极端值的影响,但不能自动修好重尾估计、异常数据或时间泄漏。若用分类预测上涨,必须区分logit(任意实数分数)与概率(0到1)。数值稳定的二分类交叉熵直接吃logit;不要先sigmoid再传BCEWithLogitsLoss。
z=0时p=1/2;标签y=1,损失约0.6931、梯度−0.5。沿负梯度更新能提高分数,但p高不保证盈利:若70%概率赚1bp、30%概率亏4bp,期望为 \(0.7-1.2=-0.5\)bp,尚未算成本。方向、幅度和决策损失要分别核对。
dropout在训练时随机置零部分激活并缩放保留值;它不是随机删除训练样本。训练与评估模式必须切换。BatchNorm跨批次估计统计量,LayerNorm通常在每个token的隐藏维度上归一化;它们既不等价,也不能替代只用训练期拟合的特征预处理。网络越大越能拟合训练样本,也可能更容易记住噪声;先比较同一数据边界下的线性、树模型与简单序列基线。
自测:分类准确率提高而成本后收益下降,是否证明实现错误?答案:未必。损失、收益幅度、仓位、换手与成本不同;先拆开验证,再定位。
优化基础一:梯度与反向传播 核心必会
训练网络就是寻找一组参数,让预测误差较小。损失函数把“错得多严重”变成数值;梯度告诉我们每个参数增加一点,损失在当前位置会怎样变化。梯度不是下一次收益的预测,也不是参数应该直接取的值。先看只有一个参数的目标 \(J(w)=(w-3)^2/2\)。它在 \(w=3\) 时为零,在 \(w=0\) 时为 \(9/2=4.5\)。导数 \(g=dJ/dw=w-3\),所以初始梯度是 \(-3\):增加一点 \(w\) 能降低损失。
导数为何是 \(w-3\)?令中间量 \(r=w-3\),则 \(J=r^2/2\)。先对 \(r\) 求导得到 \(dJ/dr=r\),再乘 \(dr/dw=1\),因此 \(dJ/dw=r\times1=w-3\)。这个“从结果沿运算链往回乘”的规则就是链式法则;反向传播把同样的规则用于网络,并复用公共中间结果。
真正算一次两层网络的反向传播
输入 \(x=2\),目标 \(y=3\),模型先计算 \(z=ax\),再计算 \(h=\max(0,z)\),最后输出 \(\hat y=bh\)。\(\max(0,z)\) 叫 ReLU:负数变零,正数保留。初始 \(a=b=1\),所以前向过程为 \(z=2,h=2,\hat y=2\),损失 \(J=(\hat y-y)^2/2=1/2\)。反向第一步 \(dJ/d\hat y=\hat y-y=-1\);第二步 \(d\hat y/db=h=2\),所以 \(dJ/db=(-1)\times2=-2\)。传向隐藏层有 \(dJ/dh=(-1)\times b=-1\)。由于 \(z=2>0\),ReLU 此处导数为 1,故 \(dJ/dz=-1\)。最后 \(dz/da=x=2\),得到 \(dJ/da=-2\)。
学习率 \(\eta=0.1\) 表示沿负梯度走多远。两个参数都用旧参数处计算的梯度同时更新,\(a'=1-0.1(-2)=1.2,b'=1.2\)。重新前向得 \(\hat y'=1.2\times(1.2\times2)=2.88\),新损失为 \((2.88-3)^2/2=0.0072\),确实下降。若算完 \(b\) 的梯度就先更新 \(b\),再算 \(a\) 的梯度,已经改变了求导点,不是这一次标准反向传播。
向量情形只是同时保存多个偏导数:\(\nabla J=(\partial J/\partial w_1,\ldots,\partial J/\partial w_d)\)。计算图是运算及其依赖关系的记录;自动微分根据图计算精确到浮点误差的链式导数,不是依靠试很多个参数变化来估计。小批量是一次取一部分样本估计梯度,因而梯度可能含噪声。量化中还要注意同一天股票、相邻时间窗口往往相关,不能把批量大小当作独立样本数量。
自测与答案
若初始 \(a=-1,b=1,x=2\),ReLU 分支发生什么?答:\(z=-2,h=0\),\(dJ/db=0\),ReLU 负区间导数为零使 \(dJ/da=0\)。即使误差大,梯度也可能为零;先检查激活与计算图,不应只把学习率调大。
RNN:把历史压进一个不断更新的状态
核心必会:能手算一次状态更新,说明反向传播为什么要穿过时间,并判断梯度如何缩小或放大。RNN(循环神经网络)在各时间点复用同一组参数,适合建立序列模型基线;是否值得采用,需要在相同数据与验证规则下比较。
先把输入、状态和目标分清
假设我们每天观察两个特征:当天收益率与成交量变化。一天的输入是长度为 2 的向量 \(x_t\);\(t\) 表示第几天。模型还保留一个长度为 \(H\) 的内部摘要 \(h_t\),称为隐藏状态。它不是实际账户持仓,而是模型自己学出的数字。\(F\) 表示每个时间点的特征数,例中 \(F=2\)。状态按下面的规则更新:
\(W_x\) 的形状是 \(H\times F\),把输入变为 \(H\) 个数字;\(W_h\) 的形状是 \(H\times H\),把旧摘要变为新摘要的原材料;\(b\) 是 \(H\) 维偏置。\(\tanh\) 逐元素把数值压到 −1 与 1 之间,提供非线性。若没有这一步,叠加很多步仍只是输入的线性组合。最后可用 \(\hat y_{t+1}=w^Th_t+c\) 预测下一天的一个目标,\(w\) 是 \(H\) 维权重,\(c\) 是标量偏置。
手算一个最小例子:只有一个输入和一个状态,设 \(h_0=0\)、\(W_x=1\)、\(W_h=0.5\)、\(b=0\),输入依次是 \(x_1=1,x_2=0\)。第一天 \(a_1=1+0.5\times0=1\),故 \(h_1=\tanh(1)\approx0.7616\)。第二天 \(a_2=0+0.5\times0.7616=0.3808\),故 \(h_2\approx0.3634\)。虽然第二天输入为零,第一天的信息仍通过状态留下了影响。
BPTT:最后的误差怎样回到第一天
BPTT 是“沿时间展开的反向传播”:先把两天的同一个单元画成先后两次计算,再从最后的损失往前求导。同一参数在每一天都使用,所以参数梯度要把各天的贡献相加。这里先只看对初始状态的梯度。对标量 RNN,\(\tanh'(a)=1-\tanh^2(a)\),因此:
代入刚才的结果:第一段导数是 \((1-0.7616^2)\times0.5\approx0.2100\),第二段是 \((1-0.3634^2)\times0.5\approx0.4340\),乘起来约 \(0.0911\)。若损失对 \(h_2\) 的导数为 1,对 \(h_0\) 的导数便只有约 0.0911。不是第一天没有用,而是经过多次乘法后训练信号弱了。
为了单独看乘法效应,令所有输入和状态都为零,此时 \(\tanh'(0)=1\)。若循环权重为 0.5,两步的导数就是 \(0.5^2=0.25\),二十步则为 \(0.5^{20}\approx9.54\times10^{-7}\),这叫梯度消失。若权重为 2,两步就是 4,二十步为 1,048,576,这叫梯度爆炸。真实向量模型要看一串雅可比矩阵的乘积;不能仅凭某个权重绝对值大于 1 就断言一定爆炸,因为激活函数与方向也参与乘法。
梯度裁剪是把过大的总梯度按比例缩短:若范数 \(\|g\|\) 大于阈值 \(c\),改用 \(cg/\|g\|\)。它控制本次更新的幅度,不能恢复已经消失的长期信号。截断 BPTT 是只让梯度回传最近若干步,以节约内存;隐藏状态可以继续传递,但更早的梯度被人为截断,不能声称模型学到了任意远的依赖。状态跨批次携带时必须保证是同一资产、正确时间顺序,并在规定边界清零,验证集不能继承训练后面时间点的状态。
LSTM 与 GRU:为什么多几扇门会改变记忆方式
核心必会:LSTM 区分“长期记忆”与“对外输出”,GRU 用一个状态完成更新;门是可学习的逐元素系数,不是人工指定的 if 判断。
LSTM 的一小步,每个数都算出来
LSTM 表示长短期记忆网络。除 \(h_t\) 外,它引入记忆状态 \(c_t\)。先把旧输出 \(h_{t-1}\) 与新输入 \(x_t\) 拼接,再经过不同的线性层。符号 \(\sigma(z)=1/(1+e^{-z})\) 把数变为 0 到 1;\(\odot\) 表示相同位置的数字相乘。
遗忘门 \(f_t\) 决定旧记忆保留几成;输入门 \(i_t\) 决定候选内容 \(g_t\) 写入几成;输出门 \(o_t\) 决定本步向外露出多少。比如标量旧记忆为 0.4,本步三个门的线性层输出都为 0,因此 \(f=i=o=\sigma(0)=0.5\)。候选内容的线性层输出取 \(\operatorname{arctanh}(0.2)\approx0.2027\),经过 tanh 后 \(g=0.2\)。于是旧记忆保留 \(0.5\times0.4=0.2\),新内容写入 \(0.5\times0.2=0.1\),合计 \(c_t=0.3\);向外输出 \(h_t=0.5\tanh(0.3)\approx0.1457\)。记忆 0.3 和输出 0.1457 是不同变量。
沿记忆加法通道、暂时固定门值时,\(\partial c_t/\partial c_{t-1}=f_t\)。如果门接近 1,这条直接路径可以保留较强梯度;但门值也依赖旧状态,完整梯度还有其他路径。因此“LSTM 彻底解决梯度消失”是错误回答。它提供更容易学习长期信息的结构,实际仍受门饱和、数据与序列长度影响。
GRU 与参数量为什么不同
GRU 是门控循环单元,没有独立的 \(c_t\)。在一种常见写法中,重置门 \(r_t\) 控制旧信息怎样参与候选状态,更新门 \(z_t\) 控制旧状态保留比例:
这里候选状态采用 PyTorch 的计算顺序:先对旧状态做线性变换,再乘重置门。其他文献可能先重置再线性变换,通常不等价。若 \(h_{t-1}=0.4,n_t=0.2,z_t=0.75\),输出是 \(0.25\times0.2+0.75\times0.4=0.35\);\(z\) 越大越偏向保留旧状态,回答前要先说明使用哪个门的定义。
单层、单方向、无投影时,RNN 有一套输入矩阵与循环矩阵;LSTM 有四套(四种门/候选);GRU 有三套。若每套采用一个偏置,参数分别是 \(H(F+H+1)\)、\(4H(F+H+1)\)、\(3H(F+H+1)\)。PyTorch 为输入与循环各保留一个偏置,所以计数中的 1 改为 2。取 \(F=2,H=3\),单偏置 LSTM 为 \(4\times3\times6=72\),PyTorch 为 \(4\times3\times7=84\)。实际面试应说明偏置约定、方向数与层数;双向模型不只是把最后输出变大,参数也增多。
双向 RNN 在同一个窗口内从前往后、从后往前各算一次。如果窗口完全位于预测时刻之前,最终窗口输出可以用于预测未来;但不能让每个时刻的输出读取它之后尚未发生的数据,再声称是逐时刻实时预测。是否泄漏由任务的信息边界决定,不能仅凭“bidirectional”这个名字判断。
注意力:用可计算的相似度选择历史信息
核心必会:理解 Q、K、V 的来源、矩阵尺寸、softmax 数值和 mask 的作用。注意力不是“模型自动理解重要性”的解释,而是一套可写下来的加权求和。
先算两个 token,不背整张结构图
token 在这里就是序列中的一个位置,可以是一分钟、一日或一个时间块,不一定是词。一个样本 \(X\) 有 \(L\) 行、\(D\) 列:\(L\) 是位置数,\(D\) 是每个位置的表示维数。用三个可训练矩阵得到查询 \(Q=XW_Q\)、键 \(K=XW_K\)、值 \(V=XW_V\)。查询表示“我用什么特征找信息”,键用于与查询比较,值是实际被聚合的内容。单个头若键维度为 \(d_k\)、值维度为 \(d_v\),则 \(Q,K\) 的尺寸为 \(L\times d_k\),\(V\) 为 \(L\times d_v\)。
\(S\) 是 \(L\times L\) 的分数表,第 \(i\) 行给位置 \(i\) 对各位置的评分。softmax 对每行分别计算,得到非负且和为 1 的权重。设两个位置经过投影后的查询、键、值分别是 \(Q=(1,0)^T\)、\(K=(0,\ln3)^T\)、\(V=(2,6)^T\),它们都是两行一列,所以 \(d_k=1\)。分数表第一行为 \((0,\ln3)\),指数变成 \((1,3)\),除以总和 4 得权重 \((1/4,3/4)\),输出为 \(2/4+18/4=5\)。第二行查询为零,分数均为零,权重各 1/2,输出为 4。整个输出为 \(O=(5,4)^T\)。这些数是一个投影后的玩具算例,不能把第二行“平均”误解成任何输入都会平均。
为什么除以 \(\sqrt{d_k}\)?若查询和键各分量近似独立、零均值且方差为 1,点积是 \(d_k\) 个乘积之和,方差约为 \(d_k\)。除以平方根后方差约为 1,避免维度增长单独把 softmax 推向非常尖锐的分布。这是基于假设的尺度分析,不是所有训练分布下的严格方差保证。
causal mask 和 padding mask 解决不同问题
causal 表示因果可见性:第 \(i\) 个位置只能看自己及更早位置。把所有 \(j>i\) 的分数在 softmax 之前设为负无穷,指数便为零。上例第一行变成 \((0,-\infty)\),权重为 \((1,0)\),输出从 5 变成 2;第二行不变,输出仍为 4。不能在 softmax 之后简单把未来权重清零而不重新归一化,否则剩余权重之和不再是 1。
padding 是为了凑成同长批次而补入的空位置。padding mask 禁止把空位置当成键参与加权;它不必自动把空查询的输出变为零,所以计算损失、池化或取最后状态时,还必须避开空位置。若某行的所有键都被屏蔽,softmax 可能出现未定义结果,数据与 mask 必须保证有效查询至少有一个可见键。
对一个只含过去的窗口预测下一天,窗口内部使用双向 attention 可以合法;对同一长序列里的每个时刻同时训练下一步目标,就需要 causal mask。两者任务不同。即使 mask 完全正确,全数据标准化、使用收盘后才发布的特征、未来修订数据、跨集合重叠标签也仍可能泄漏;mask 只约束 attention 读哪些位置。
Transformer:把注意力、逐位置网络与稳定训练通道接起来
核心必会:能顺着形状讲完一个 block,区分归一化位置,知道位置编码缺失时丢掉什么;RoPE 与缓存作为进阶理解,不把是否背过所有变体当作基础能力。
完整的 Pre-LN block
block 是反复堆叠的基本计算单元。Pre-LN 表示先做 LayerNorm,再进入注意力或前馈网络。LayerNorm 是对每个位置自己的 \(D\) 个特征做标准化,随后用可学习的缩放和平移调整;它不沿时间轴收集未来样本。若一个位置的特征是 \((1,3)\),均值为 2、方差为 1,忽略很小的数值稳定常数后标准化结果为 \((-1,1)\)。可学习缩放初始取 1、平移取 0 时结果不再改变。
MHA 是多头注意力;MLP 是多层感知机,在这个 block 中通常是两层线性变换加激活函数。残差中的加号要求前后形状一致,都是 \(B\times L\times D\),\(B\) 为批量内样本数。残差让子模块学习对输入的修正,并给梯度提供直接路径;它不是把信息无损保留的保证。Dropout 在训练时随机把部分激活置零并缩放剩余激活,以减少对固定神经元组合的依赖;推理时需切换 eval 模式关闭随机丢弃。
多头不是把序列分成几段,而是用几组投影从不同表示子空间计算 attention。若 \(D=8\)、头数为 2,每个头用 4 维键和值,分别得到 \(B\times L\times4\) 输出;按特征维拼回 8 维,再乘一个 \(8\times8\) 输出矩阵。一般实现要求 \(D\) 能被头数整除。各头能学习不同关系,但不保证每头自动对应一个可解释的金融概念。
MLP 对每个位置使用同一套参数,不在这一子层内混合不同时间点。设 \(D=8\),中间宽度 \(D_{ff}=32\),第一层把 8 维变为 32 维,做 GELU 等逐元素非线性,再由第二层回到 8 维,才能与残差相加。时间点之间的交流主要来自 attention。Post-LN 则在残差相加之后归一化;原始 Transformer 采用 Post-LN,这里解释和代码使用 Pre-LN,不能把两种计算顺序混为一谈。
为什么必须给模型时间位置
没有位置机制与其他顺序线索的全可见自注意力,对输入排列是等变的:把 token 顺序打乱,输出也按同样方式重排,模型不能仅靠这一层区分“先涨后跌”和“先跌后涨”。绝对位置编码直接给每个位置加上不同向量;正弦编码用不同频率的 sin、cos 构成向量,学习式编码则把位置向量作为参数。
RoPE 是旋转位置编码:将查询和键的相邻两维看作二维向量,在位置 \(p\) 旋转角度 \(p\theta\)。二维旋转矩阵为:
取 \(q=k=(1,0)^T\),\(\theta=\pi/2\)。位置 0 的查询为 \((1,0)\),位置 1 的键变成 \((0,1)\),点积为 0;位置 1 的查询与位置 2 的键为 \((0,1)\) 和 \((-1,0)\),点积仍为 0。两对位置都相差一步。一般地 \(q_p^Tk_s=q^TR((s-p)\theta)k\),点积含有相对位置差。实际模型给不同二维对使用不同频率,并不会只用这个四步循环的玩具频率;能处理更长输入不等于长序列外推精度必然可靠。这里只解释 RoPE,下面最小代码用学习式位置编码,两者不要叠加理解为同一实现。
训练、推理与 KV cache:先说清在算哪一种任务
设单层隐藏宽度为 \(D\),序列长为 \(L\),忽略批量系数。RNN 每步主要算输入映射和状态映射,总工作量约 \(O(L(FH+H^2))\),且状态必须按时间顺序更新。标准全注意力的分数与加权和各需约 \(O(L^2D)\),QKV 投影还需 \(O(LD^2)\),MLP 约 \(O(LDD_{ff})\)。因此“Transformer 复杂度就是平方”省略了宽度项;短序列大模型也可能由投影与 MLP 主导。朴素实现 attention 权重需 \(O(L^2)\) 内存,FlashAttention 等实现能避免把完整权重表写入高带宽显存,但一般全注意力的精确计算量并不因此变为线性。
训练时,causal mask 允许一次喂入整段序列并并行计算各位置的下一步预测,因为答案只用于损失,未来 token 通过 mask 隔离。推理时,若每步真的需要上一步预测结果作为下一步输入,自回归生成必须一个位置接一个位置。不要把“训练并行”说成“未来所有步可以同时生成”。
KV cache 是把已算过的各层键和值保存下来。假设已经有 \(L\) 个历史位置,新位置只计算自己的 QKV,并用新查询与缓存的 \(L\) 个键比较,attention 的新增工作约为 \(O(LD)\),另有投影与 MLP 工作;缓存容量每层约 \(O(LD)\)。它省去反复重算历史 token,但每层都要存缓存,不是只存输入层。不能说整个生成过程只需 \(O(L)\):连续生成 \(T\) 步时,各步注意力读到的历史越来越长,要对各步成本求和。
常规双向 encoder 的历史表示会在加入新 token 后改变,因为旧位置现在也能看见新位置,旧 K/V 不一定继续有效。因果模型的旧位置看不见未来,才容易精确复用缓存。量化中的滚动窗口还有特殊问题:删掉最旧一天后,相对位置、窗口归一化和先前隐藏表示可能改变;不能直接把语言模型 append-only 缓存照搬为固定窗口的精确推理。预测明日一个数的 encoder 通常一次编码整段历史后接一个回归头,不需要自回归 KV cache。
一个最小因果预测器:输入历史,输出一个未来目标
下面输入形状为 \(B\times L\times F\),输出 \(B\times1\)。假设每条样本已经整理为等长、无 padding 的过去窗口,最后位置的输出用于预测窗口之后的目标。模型包含输入投影、学习式绝对位置编码、Pre-LN encoder block、最终归一化和回归头。causal mask 的上三角为 True,表示这些未来位置不可见;这是 nn.Transformer 的布尔 mask 约定,不能直接套到所有 attention API。模型结构可运行不代表数据与回测已经正确。
import torch
from torch import nn

class CausalRegressor(nn.Module):
    def __init__(self, features=3, width=16, heads=2, max_len=64):
        super().__init__()
        self.project = nn.Linear(features, width)
        self.position = nn.Embedding(max_len, width)
        layer = nn.TransformerEncoderLayer(
            d_model=width, nhead=heads, dim_feedforward=4 * width,
            dropout=0.0, activation="gelu", batch_first=True,
            norm_first=True)
        self.encoder = nn.TransformerEncoder(
            layer, num_layers=2, enable_nested_tensor=False)
        self.norm = nn.LayerNorm(width)
        self.head = nn.Linear(width, 1)

    def forward(self, x):  # x: [B, L, F], no padding
        length = x.shape[1]
        if length > self.position.num_embeddings:
            raise ValueError("sequence exceeds max_len")
        positions = torch.arange(length, device=x.device)
        h = self.project(x) + self.position(positions)[None, :, :]
        blocked = torch.ones(length, length, dtype=torch.bool,
                             device=x.device).triu(diagonal=1)
        h = self.encoder(h, mask=blocked)
        return self.head(self.norm(h[:, -1]))  # [B, 1]

if __name__ == "__main__":
    torch.manual_seed(7)
    model = CausalRegressor()
    x = torch.randn(4, 12, 3)
    target = torch.randn(4, 1)
    prediction = model(x)
    assert prediction.shape == (4, 1)
    loss = nn.functional.mse_loss(prediction, target)
    loss.backward()
    assert torch.isfinite(loss)
    assert all(torch.isfinite(p.grad).all()
               for p in model.parameters() if p.grad is not None)
如果样本有 padding,必须另外传入键填充 mask,并按实际长度取最后有效位置,不能继续盲取 \(h[:,-1]\)。这份代码只使用训练窗口允许的输入,不包括数据切分、特征标准化、训练循环与交易成本;它的验收是形状与梯度正确,不能用一次随机输入成功推出预测有效。数值目标要固定含义,例如次日对数收益;不同预测期限或净收益目标不能混着比较。
面试自测:先独立回答,再核对
- RNN 的权重每个时间点都不同吗?不,时间上共享同一套参数,反向时汇总各时间点对它的梯度;否则参数数会随窗口长度增长,也改变了模型定义。
- 把 RNN 换成 LSTM 就不用裁剪梯度了吗?不是。加法记忆路径改善传播,但其他路径与训练状态仍可能造成不稳定;应检查梯度范数与损失,再决定裁剪阈值。
- 两个键的分数都是 0,值为 2 和 6,输出多少?屏蔽第二键后呢?指数均为 1,权重各半,输出 4;屏蔽后第二键权重为零、第一键为 1,输出 2。
- attention 的 \(L\times L\) 表与 batch 有什么关系?每个样本、每个头各有一张表;常见逻辑形状为 \(B\times n_h\times L\times L\)。高效实现可能不实际存下整张表。
- Pre-LN 与 Post-LN 区别在哪?前者先归一化再进入子层、再与残差相加;后者先子层与残差相加、再归一化。它们不是同一公式换个名字。
- 过去 20 日都已知,用双向 encoder 预测第 21 日合法吗?可以,前提是输入特征在决策时都已知;若用第 20 日的完整窗口回头评估第 5 日的实时预测,就产生泄漏。
- 收益预测 MSE 更低,就应马上交易吗?不能。还需检查可交易时间、方向与排序稳定性、成本、换手、容量,以及真实成交规则。模型评估指标与经济结果是不同验收对象。
优化基础二:用同一题算懂五种更新 核心必会
以下全部从 \(J(w)=(w-3)^2/2,w_0=0,\eta=0.1\) 独立开始,\(g_t=w_{t-1}-3\)。不同优化器第二步的参数已经不同,因此不能给它们强行使用同一个第二步梯度。为手算清楚暂令防止除零的 \(\epsilon=0\),因为这里分母均非零;实际程序必须使用正的小数。演示参数用于理解,不是量化训练推荐值。
SGD:只看当前方向
更新式 \(w_t=w_{t-1}-\eta g_t\)。第一步 \(g_1=-3\),\(w_1=0-0.1(-3)=0.3\);第二步 \(g_2=0.3-3=-2.7\),\(w_2=0.3+0.27=0.57\)。虽然这道确定性题没有抽样,仍可用 SGD 的更新公式。真实小批量训练中,SGD 用随机选取的样本近似全量梯度。
Momentum:保存带方向的惯性
本节明确采用 \(u_t=\mu u_{t-1}+g_t,w_t=w_{t-1}-\eta u_t\),取 \(u_0=0,\mu=0.9\),无阻尼、无 Nesterov。第一步 \(u_1=-3,w_1=0.3\)。第二步 \(g_2=-2.7,u_2=0.9(-3)-2.7=-5.4\),因此 \(w_2=0.3+0.54=0.84\)。连续同向的梯度累积,来回变化的梯度部分抵消。另有教材写 \(u_t=\mu u_{t-1}+(1-\mu)g_t\),若学习率不相应调整,数值不会与这里一样;面试先说明约定。
AdaGrad:累计每个坐标走过的梯度平方
令 \(s_t=s_{t-1}+g_t^2\),更新 \(w_t=w_{t-1}-\eta g_t/(\sqrt{s_t}+\epsilon)\)。第一步 \(s_1=9\),\(w_1=0-0.1(-3)/3=0.1\)。第二步 \(g_2=-2.9,s_2=9+8.41=17.41\),于是 \(w_2=0.1+0.29/\sqrt{17.41}\approx0.169502\)。多维参数各有自己的 \(s\):历史梯度平方大的坐标,之后被更强地缩小。问题是累计量只增不减,有效步长可能越来越小。
RMSProp:只保留逐渐衰减的平方历史
把累计改成指数平均:\(v_t=\rho v_{t-1}+(1-\rho)g_t^2\),更新仍除以 \(\sqrt{v_t}+\epsilon\)。取 \(\rho=0.9,v_0=0\)。第一步 \(v_1=0.1\times9=0.9\),\(w_1=0.3/\sqrt{0.9}\approx0.316228\)。第二步 \(g_2\approx-2.683772\),\(v_2=0.9\times0.9+0.1(-2.683772)^2\approx1.530263\),故 \(w_2=0.316228+0.2683772/\sqrt{1.530263}\approx0.533179\)。这是未居中、无动量的版本;开头没有 Adam 那样的偏差校正。
Adam:方向平均加平方平均,再校正冷启动
令 \(\beta_1=0.9,\beta_2=0.999,m_0=v_0=0\)。\(m\) 保存带正负号的梯度平均,\(v\) 保存梯度平方平均:
\[m_t=\beta_1m_{t-1}+(1-\beta_1)g_t,\qquad v_t=\beta_2v_{t-1}+(1-\beta_2)g_t^2.\] \[\hat m_t=\frac{m_t}{1-\beta_1^t},\qquad\hat v_t=\frac{v_t}{1-\beta_2^t}.\] \[w_t=w_{t-1}-\eta\frac{\hat m_t}{\sqrt{\hat v_t}+\epsilon}.\]第一步 \(m_1=-0.3,v_1=0.009\),校正后 \(\hat m_1=-0.3/0.1=-3,\hat v_1=0.009/0.001=9\),所以 \(w_1=0.1\)。第二步 \(g_2=-2.9\),\(m_2=0.9(-0.3)+0.1(-2.9)=-0.56\),\(v_2=0.999(0.009)+0.001(8.41)=0.017401\)。除以 \(1-0.9^2=0.19\) 和 \(1-0.999^2=0.001999\),得到 \(\hat m_2\approx-2.947368,\hat v_2\approx8.704852\),因此 \(w_2\approx0.199897\)。
为什么除这两个数?假设梯度始终等于常数 \(g\),第一步平均只有 \((1-\beta)g\);递推展开得 \(m_t=(1-\beta)(1+\beta+\cdots+\beta^{t-1})g=(1-\beta^t)g\),除掉前面的系数就恢复 \(g\)。真实梯度会变化,因此校正主要去除零初始化造成的权重总量不足,不代表已经得到无噪声真梯度。Adam 分母是平方的平均开方,不是梯度的标准差,因为没有减去均值平方。
自测与答案
为什么不能说 Adam 的学习率就是每个参数实际移动的距离?答:还要乘 \(\hat m/(\sqrt{\hat v}+\epsilon)\)。若梯度长期同号且大小相似,该比值接近正负 1,但梯度反向、波动或极小时就不成立。以上例子也不能证明哪种方法普遍更好,只比较了各自规则。
优化基础三:AdamW、正则与衰减 核心必会
L2 正则在原损失增加 \(\lambda\|w\|^2/2\),\(\lambda\) 是惩罚强度。对一个参数求导得到额外的 \(\lambda w\),因此把梯度变成 \(g+\lambda w\)。普通无动量 SGD 的更新可改写为 \(w'=w-\eta(g+\lambda w)=(1-\eta\lambda)w-\eta g\)。这里 L2 与直接乘衰减系数确实相同。
自适应方法会给不同坐标不同缩放。先把当前缩放简记成 \(d\),L2 形式是 \(w'=w-\eta d(g+\lambda w)\),其中参数惩罚也乘上 \(d\);解耦衰减是 \(w'=(1-\eta\lambda)w-\eta d g\)。两者的衰减分别为 \(\eta d\lambda w\) 与 \(\eta\lambda w\),除特殊条件外不同。对真实 Adam,差异更多:把 \(\lambda w\) 混进梯度,还会改变之后的 \(m,v\) 历史;AdamW 仅用数据梯度更新这些历史,并独立收缩参数。
数值核验:取 \(w=2,g=1,\eta=0.1,\lambda=0.1\),Adam 的初始状态为零,沿用前节参数并忽略 \(\epsilon\)。带 L2 的 Adam 收到梯度 \(1+0.1\times2=1.2\),第一步校正后方向为 \(1.2/\sqrt{1.44}=1\),得到 \(w'=1.9\)。AdamW 收到梯度 1,先独立衰减 \(2(1-0.1\times0.1)=1.98\),再减 \(0.1\times1\),得到 \(1.88\)。两者不是更换名字的同一算法。
实践可把偏置、归一化的缩放参数单独设置是否衰减;这是建模选择,不能声称所有网络都应该采用同一分组。量化研究要用按时间划分的验证集调 \(\lambda\),并保持试验次数记录;训练损失更低或衰减更强,都不自动意味着样本外预测更好。
自测与答案
损失里手工加 L2,又给 AdamW 设置 weight_decay,会怎样?答:两种惩罚同时生效,L2 还进入自适应状态,通常不是你原先打算的单次衰减。实现前明确要惩罚损失还是解耦缩参数。
优化基础四:学习率与可靠训练步骤 研究重点
学习率过大可能跨过低损失区甚至发散,过小则改进缓慢。Warmup 是开头若干次更新逐步升到目标学习率,让状态与梯度尺度有适应时间;它不是任何架构都必需。余弦衰减可在 warmup 之后使用:剩余阶段的更新序号 \(s=0,\ldots,T\) 对应 \(\eta_s=\eta_{\min}+(\eta_{\max}-\eta_{\min})(1+\cos(\pi s/T))/2\)。开始为最大值,中点为最大最小值的平均,最后为最小值。日历天、epoch、微批次和参数更新次数是不同单位,调度前先定义单位。
梯度裁剪限制一次更新前的梯度整体长度。若梯度向量为 \((3,4)\),长度为 5,而阈值为 2,则整体乘 \(2/5\),得到 \((1.2,1.6)\),方向保留。逐坐标截断不是同一种规则。裁剪可缓和 RNN 等模型的梯度爆炸,却不能修复未来信息泄漏,也不能让坏标签变好。
梯度累积把多个微批次的梯度相加后只更新一次。若 K 个微批次大小一致,对每个平均损失再除以 K,累积后就是大批次平均梯度。最后一组不足 K 个,应除以实际组大小;若样本数不等,应按样本数加权。Dropout 随机性、BatchNorm 统计和浮点运算顺序会使结果不必严格等于一次大批次前向。
下面是完整的基础训练函数:loader 每个批次大小相同,最后不足一组时自动处理;模型、数据已经移到同一个 device。调度器按成功的参数更新调用,而不是每个微批次调用。为突出顺序,代码采用全精度。
import torch

def train_epoch(model, loader, optimizer, scheduler, device, accum=4):
    model.train()
    optimizer.zero_grad(set_to_none=True)
    n = len(loader)
    for i, (x, y) in enumerate(loader):
        # Each microbatch has the same sample count.
        group_start = (i // accum) * accum
        group_size = min(accum, n - group_start)
        pred = model(x.to(device))
        loss = torch.nn.functional.mse_loss(pred, y.to(device))
        (loss / group_size).backward()
        if (i + 1) % accum == 0 or i + 1 == n:
            torch.nn.utils.clip_grad_norm_(model.parameters(), 1.0)
            optimizer.step()
            if scheduler is not None:
                scheduler.step()  # configured per optimizer update
            optimizer.zero_grad(set_to_none=True)

# Example: create model first, then run train_epoch.
# optimizer = torch.optim.AdamW(model.parameters(), lr=1e-3,
#                               weight_decay=1e-2)
AMP 是自动混合精度:选择部分算子用低精度以减少显存和计算成本,并不是把所有变量都改成半精度。FP16 的 GradScaler 先放大损失,使微小梯度不容易下溢;反向后必须先还原梯度,再裁剪。否则你裁剪的是放大后的梯度,会改变有效阈值。使用顺序是 autocast前向 → scale(loss).backward → 整组累积完成 → unscale_(optimizer) → clip_grad_norm_ → scaler.step(optimizer) → scaler.update → zero_grad。整组使用同一 scale,不能每个微批次 update。出现非有限梯度时 scaler 可跳过参数更新,此时按更新次数设计的 scheduler 也应跳过,并记录异常。BF16 的范围不同,不应机械地照搬 FP16 必须缩放的判断。
面试回答顺序:先说明损失和数据批次,再写梯度,再说明优化器状态与更新;最后说验证与排错。选读内容如 Nesterov、AMSGrad、二阶近似优化器,先知道解决什么问题即可,除非具体岗位要求,不必挤占链式法则、AdamW、训练循环与时间切分的复习时间。
自测与答案
累积四个微批次,每个都调用一次 scheduler,但只调用一次 optimizer.step,问题是什么?答:调度进度以微批次跑快四倍;原定一万次参数更新的学习率计划在约二千五百次更新时就结束。若 scheduler 本来按 epoch 配置,则应每个 epoch 调一次,不能套用此处规则。
前沿架构知识地图:先分清在改哪一种资源
研究岗重点,机制优先;论文动态截至2026年10月24日核验。“新模型”不是一种共同的运算。面对一个名字,先问:它在增加可储存的参数、改变每个token的计算、增加训练监督,还是改变一次预测内部执行的步数?下面三条路线可以组合,但各自要付不同代价。
| 路线 | 主要改变 | 必须一起追问 |
|---|---|---|
| MoE:混合专家 | 在许多参数化子网络中稀疏选择少数,扩展条件计算容量 | 总参数、每token激活量、权重驻留显存、跨设备通信和尾部延迟分别是多少? |
| MTP:多token预测 | 在同一前缀或递进状态上增加未来位置的训练目标 | 各头看到了什么?标签如何移位?推理是否使用这些头、怎样验证草稿? |
| Looped Transformer:深度循环 | 同一主干块反复加工隐藏状态,用计算换有效深度 | 共享哪些参数?训练循环数与测试循环数如何匹配?什么时候停止? |
一个教学组合:四个专家中每次选两个,主干重复三次。每个位置总共发生六次专家调用;仍只储存四个不同专家,而不是凭空长出十二个。若另外加两个未来预测头,这又会增加训练目标和相应模块的计算。不能把“三次循环”“两个预测头”和“两倍推理加速”相互替换。
同样需要分清工程路线。FlashAttention主要通过分块、重算和访存组织避免显式保存完整注意力矩阵,原始机制仍计算softmax注意力;它不是通过共享深度参数来做循环。MLA等缓存压缩方法改变缓存表示与投影,不能等同于MoE稀疏专家。KV cache存储过去位置的表示,也不能自动证明某个循环架构能复用同一份缓存。
面试回答的基本次序:输入和状态 → 一步运算 → 多步展开 → 训练信号 → 参数/计算/显存/通信 → 失效例 → 在目标岗位怎样验证。新论文中的模型名称与基准成绩应放在这个机制骨架之上,而不是替代它。
MoE:每个位置只调用一部分专家
研究岗进阶:先学会已有 Transformer 的注意力与 FFN,再学习这一节。MoE(Mixture of Experts,混合专家)通常把层中的单个前馈网络换成多个前馈网络及一个路由器。专家只是不同参数的网络,并非人工标注的“科技股专家”“债券专家”。路由器根据当前 token 的表示,选出要计算的专家;选中谁、怎样加权,是两件事。这里介绍可复用的架构机制,不能据此称它是量化公司的高频考题。
四个专家、只选两个:把一次计算走完
设当前表示为向量 \(x\),四个专家分别是 \(E_1,E_2,E_3,E_4\)。路由器对它给出非负亲和分数 \(s=(0.6,0.3,0.2,0.1)\);这些数不要求加起来等于 1。top-2 表示选择分数最高的两个,故选中集合 \(S=\{1,2\}\)。采用“在选中集合中归一化”的规则,权重分别为 \(0.6/(0.6+0.3)=2/3\)、\(0.3/(0.6+0.3)=1/3\),未选专家权重为零。
为便于手算,令专家输出为二维向量,\(E_1(x)=(3,0)\)、\(E_2(x)=(0,6)\)。第一项是 \((2,0)\),第二项是 \((0,2)\),路由结果就是 \((2,2)\)。第三、第四专家即使有很大输出,也没有进入本次结果,因为它们没有被调用。若这一层另有共享专家,输出为 \(E_s(x)=(1,-1)\),先相加得到 \((3,1)\);若含残差且 \(x=(1,2)\),层输出再加输入,成为 \((4,3)\)。共享专家每个 token 都计算,路由专家按选择计算;共享参数不等于共享专家。
不同论文的分数函数与归一化约定可能不同,例如先 softmax 再 top-k,或先 sigmoid 再对选中的值归一化。不能只看“top-2”便假设所有实现相同。DeepSeekMoE 强调细粒度路由专家与共享专家;设计动机是让共享部分承担通用计算,让路由组合更灵活,不代表每个专家会自然对应可解释的业务类别。原论文:DeepSeekMoE。
总参数、激活参数、显存与速度,为什么要分别回答
设四个路由专家各有 \(P\) 个参数,共享专家也有 \(P\) 个,其他注意力、嵌入、路由器合计 \(A\) 个。则总参数为 \(A+5P\);top-2 时每个 token 涉及的参数约为 \(A+3P\)。若 \(A=20\) 百万、\(P=10\) 百万,两者分别为 7000 万与 5000 万。这里是简化计数,不是 FLOPs 的严格公式:矩阵形状、序列长度、激活函数和路由操作都会影响运算量。
总参数决定权重需要存多少,激活参数描述当前 token 走了哪些计算。训练还要存梯度、优化器状态与中间激活;推理还可能有 KV cache。未选专家的权重并未凭空消失,只是不参与该 token 的专家前向。专家并行可以把权重分布在多张卡上,却引入 token 的发送与结果收回。一个批次中的不同 token 可能合起来调用全部专家;少量小矩阵、路由不均衡和跨卡 all-to-all 通信都可能让实际延迟不理想。因此应分别测吞吐、单请求延迟、显存及网络传输,而不是用“总参大但激活少”直接推出更快。
为什么路由会扎堆,容量怎么影响结果
假设一批有 8 个 token,每个选 2 个专家,共产生 16 次分配。四个专家完全均匀时各处理 4 次;若分配为 \((8,6,2,0)\),第一张卡可能忙到其他卡等待,第四专家也难以获得训练。给每专家设置容量 4,则前两个专家超出 4 次与 2 次。实现必须明确如何处理:丢弃这部分专家分支、改派、排队,或采取不丢 token 的动态调度;“MoE 必须丢 token”不成立。“容量因子”常指实际容量相对平均负载的倍率;倍率 1.5 时本例容量约 6,但是否取整、按设备还是专家统计,要查实现。
一种办法是在任务损失外加入负载均衡惩罚。它鼓励路由不要全挤到少数专家,但系数太大会让路由为平均而牺牲任务。另一类办法给专家维护路由偏置:忙的降低选择优先级,闲的提高。关键是它如何进入公式。
在 DeepSeek-V3 的规则中,用 \(s_i+b_i\) 决定 top-k,实际乘专家输出的权重仍由原始 \(s_i\) 归一化。继续用上面的四个分数,取 \(b=(0,0,0,0.55)\),选择分数变成 \((0.6,0.3,0.2,0.65)\),选中专家 4 与 1。加权时却是 \(w_1=0.6/0.7=6/7\)、\(w_4=0.1/0.7=1/7\),不能拿 0.65 做专家 4 的混合权重。该报告还保留很小的序列级均衡辅助损失;“主要均衡办法不靠辅助损失”不能说成“训练绝无辅助损失”。原报告 §2.1.2。
import torch

def route_topk(scores, expert_outputs, k=2, bias=None):
    # scores: [N, E]; expert_outputs: [N, E, D]
    # 教学版:先给出所有专家结果以核对权重,生产版应只算选中专家。
    choice = scores if bias is None else scores + bias
    indices = choice.topk(k, dim=-1).indices
    selected = scores.gather(-1, indices)  # 不使用 choice 作 gate
    weights = selected / selected.sum(-1, keepdim=True)
    picked = expert_outputs.gather(
        1, indices[..., None].expand(-1, -1, expert_outputs.size(-1)))
    result = (picked * weights[..., None]).sum(1)
    return result, indices, weights

s = torch.tensor([[0.6, 0.3, 0.2, 0.1]])
e = torch.tensor([[[3., 0.], [0., 6.], [9., 9.], [7., 7.]]])
y, idx, w = route_topk(s, e)
assert set(idx[0].tolist()) == {0, 1}
assert torch.allclose(y, torch.tensor([[2., 2.]]))
yb, ib, wb = route_topk(s, e, bias=torch.tensor([0., 0., 0., 0.55]))
assert set(ib[0].tolist()) == {0, 3}
assert torch.allclose(yb, torch.tensor([[25/7, 1.]]))
这段代码用于验证 top-k 与 gate 的区别,刻意没有冒充稀疏高性能实现;它还要求分数严格为正。真实实现还需检查溢出策略、路由梯度与并行调度。
闭卷自测
若八专家 top-2,总参数是否减少到四分之一?答:没有,只减少每个 token 调用的路由专家比例;总权重仍存在。提高某专家的均衡偏置,是否一定提高它被选中后的混合权重?答:不一定,以上规则的权重用原始分数。换一个批次后,重新统计每专家负载,而不是只看一个 token 的选择。
MTP:训练时多预测几步,与推理时多接受几步
研究岗进阶:MTP 是 multi-token prediction,多 token 预测。它首先是一类训练目标与预测模块设计,不是一个统一的网络,更不是“无需验证,一次输出几个词”的保证。先把普通语言模型写清楚:主干看到 \(x_1,\ldots,x_t\),输出状态 \(h_t\),下一 token 头给出 \(x_{t+1}\) 的概率。交叉熵就是对正确答案概率取负对数:给正确答案概率越小,惩罚越大。
并行多头:同一前缀同时承担多个未来目标
以三个头为例,头 1、2、3 分别预测 \(x_{t+1},x_{t+2},x_{t+3}\),都使用只看见前缀 \(x_{\le t}\) 的状态。头 2 不能在输入中偷看真实 \(x_{t+1}\)。这些头共享主干,却有各自的输出计算;多个概率分布来自同一个前缀,不等于已构建一个满足自回归条件依赖的联合采样过程。Gloeckle 等,2024使用共享主干上独立多头的方案;其作用与效果须结合原实验范围理解。
用教学序列 \((A,B,C,D,E)\) 手对齐。状态 \(h_A\) 的三个目标依次是 B、C、D;\(h_B\) 的三个目标是 C、D、E;\(h_C\) 只有 D、E 两个合法目标。序列末尾不存在的未来 token 必须被 mask,不能拿 padding 当真答案。每个头要明确按本头有效位置平均,还是先汇总再按总位置平均;两种权重约定一般不同。
这里 T 是完整教学序列长度、k 是向前预测的步数、\(\lambda_k\) 是各头权重。若首位置的三个正确概率为 \((1/2,1/4,1/8)\),对应损失为 \((\ln2,\ln4,\ln8)\),本例三头权重各为1/3,因此平均为(ln 2+ln 4+ln 8)/3,约1.3863。这个数只检查该位置;完整训练还要纳入其他合法位置,不能把它当整批损失。
import torch
import torch.nn.functional as F

def parallel_mtp_loss(logits, tokens, segment_ids=None):
    # tokens: [B, T]; 第 k 项 logits[k-1] 为 [B, T, V]
    # logits 必须由因果主干产生;此函数只能查对齐,不能替你防泄漏。
    losses = []
    for k, scores in enumerate(logits, start=1):
        if k >= tokens.size(1):
            raise ValueError("每个头至少需要一个合法目标")
        pred = scores[:, :-k, :]
        target = tokens[:, k:]
        valid = target.ne(-100)  # -100 表示 padding 等无效目标
        if segment_ids is not None:
            # 同一打包样本内,每段文档使用不同的 segment id。
            valid = valid & segment_ids[:, :-k].eq(segment_ids[:, k:])
        if not valid.any():
            raise ValueError("本头没有有效目标")
        losses.append(F.cross_entropy(pred[valid], target[valid]))
    return torch.stack(losses).mean()

ids = torch.tensor([[0, 1, 2, 3, 4]])
heads = [torch.zeros(1, 5, 5) for _ in range(3)]
loss = parallel_mtp_loss(heads, ids)
assert torch.allclose(loss, torch.log(torch.tensor(5.)))
assert ids[:, 2:].tolist() == [[2, 3, 4]]
assert heads[1][:, :-2].shape == (1, 3, 5)
若一个 batch 内有多段打包文档,还要让每个偏移头的 mask 排除越过文档边界的目标;仅设 padding 不够。可用segment_ids按头排除跨段目标,但每段ID须在同一打包样本内唯一。代码展示的是损失对齐,并未构造主干或注意力mask,后者也必须隔离文档。
串行模块:DeepSeek-V3 不是同一状态接几个独立头
DeepSeek-V3 的附加预测按深度串起来:第一个附加模块融合主干状态与真实 \(x_{t+1}\) 的嵌入,经过投影与因果 Transformer 块,预测 \(x_{t+2}\);下一个再接真实 \(x_{t+2}\),预测 \(x_{t+3}\)。训练时使用真实前序 token 称为 teacher forcing。它不违反该步的因果边界,因为预测 \(x_{t+2}\) 可以条件于 \(x_{t+1}\),却不能输入当前答案 \(x_{t+2}\)。推理时真实未来不存在,必须换成已经生成或草拟的前序 token。模块共享嵌入与输出头,但有额外投影和块;可在仅用主模型推理时移除。原报告 §2.2。
为什么 MTP 训练不自动等于推测解码加速
推测解码让便宜的草稿过程先提议多个 token,较贵的目标模型对提议批量验证。失败后丢弃不合法的后缀;加速取决于接受率、草稿成本、验证开销与硬件。MTP 模块可以提供草稿,也可以仅帮助训练后被丢弃,两者不能混为一谈。
若目标是保留目标模型的随机采样分布,设当前 token 草稿概率为 q、目标概率为 p,接受概率为 \(\min(1,p/q)\)。拒绝时不是简单按 p 重抽,而要从归一化的 \(\max(0,p-q)\) 校正分布采样。例如两个词的 \(q=(0.8,0.2),p=(0.5,0.5)\):草拟第一个词后以 0.625 接受,接受贡献为 \(0.8\times0.625=0.5\);第二个词必接受,贡献 0.2;拒绝概率 0.3 全补给第二个词,最终恰为 \((0.5,0.5)\)。若拒绝后直接按 p 重抽,结果反而是 \((0.65,0.35)\)。多步时逐前缀执行相应规则,并正确回滚缓存;温度、截断采样后的实际分布也必须一致纳入验证。推测解码原论文。不能将任意置信度阈值方案称为严格同分布。
量化迁移:多期收益头首先是多目标回归
在日终用同一历史分别预测 1 日、5 日、20 日收益,可以借鉴共享主干与多任务损失,但这些是连续标签,不是下一词离散采样。须先定义简单收益还是对数收益,按各目标尺度设置损失权重,并控制跨期相关性。如果训练样本在验证起点前一天,却使用未来 20 日收益作标签,它已经跨进验证期;必须按最长标签终点清除交叠样本,再比较单期与多期模型。多头训练改善预测,不等于获得交易执行加速;需要单独验证样本外预测、稳定性、换手与成本。
闭卷自测
并行头预测第三个未来词时可否输入中间真实词?答:本节并行定义不可以;串行 teacher forcing 是另一结构。长度 5 的序列中偏移 3 有多少合法目标?答:2 个。多日收益头能否照搬推测解码接受率公式?答:不能,任务与概率对象不同。
Looped Transformer:把同一个计算模块多用几遍
岗位拓展:本节适合深度学习研究与模型架构岗位;目前没有据此认定它是量化笔试的高频考点。先掌握反向传播、注意力、残差连接和优化器,再学循环深度。这里的 Loop 指深度方向的重复计算,不是简单地让模型多生成几句文字。
1.先分清:读下一个时刻,还是再想一轮?
假设输入是过去三个交易日的特征。RNN先读第一天,再读第二天,再读第三天,隐藏状态沿数据时间传递。Looped Transformer可以一次接收这三天的特征,在同一段已知历史上重复计算:第一轮得到初步表示,第二轮重新组合,第三轮继续修正。重复轮数增加,不意味着又看到了第四天的数据。输入可见范围仍由预测时点和注意力掩码限定。
普通深层Transformer通常用不同参数的模块依次变换:第一层用参数θ₁,第二层用θ₂。循环模型则反复调用同一个参数集合θ。可以把它理解为,同一个解题步骤被多次使用;每轮输入状态不同,因此输出仍能不同。共享权重并不表示每轮复制前一轮答案。
x是完整输入,E把输入转成向量;H是一张“每个位置当前理解如何”的状态表;r是循环编号,R是总轮数;F是含注意力和前馈网络的共享模块。每轮再次输入E(x)是常见的输入注入设计,可以防止原始信息逐轮丢失,但不是所有循环模型都必须采用同一注入形式。
参数共享,计算量不会共享。设共享主干有P个参数,一轮需要C次计算,R轮主干参数仍是P,前向计算约为RC。若增加每轮独立的归一化或门控,还有额外参数,不能把所有变体都说成参数完全固定。保存全部反向图时,中间激活显存也随轮数增长;参数少不等于推理快、训练省显存。
2.具体手算:多循环为什么可能有用,也可能越算越坏?
先看一个我们自己构造的标量例子,目的是理解迭代,不是模拟真实模型的推理。设固定输入x=2,初始状态h₀=0,每轮更新h′=0.5h+x。第一轮h₁=0.5×0+2=2;第二轮h₂=0.5×2+2=3;第三轮3.5;第四轮3.75。若最后稳定在h*,则h*=0.5h*+2,移项得到0.5h*=2,所以h*=4。
这一步不是凭直觉:把4=0.5×4+2从更新式两侧减掉,就得到上式。每轮误差只剩一半,因此朝4收敛。但把0.5改成1.2,h′=1.2h+2,从0开始得到2、4.4、7.28;其固定点是−10,误差每轮乘1.2,反而远离固定点。再看h′=−h,初值1会在1与−1之间永远摆动。共享模块反复调用,本身不保证收敛,也不保证预测正确。真实网络需要观察表示、损失和样本级预测,不能由这个标量例子推出神经网络必有唯一稳定解。
3.同一参数用两次,梯度怎么算?
仍用最小例子:h₀=x=2,h₁=wh₀,h₂=wh₁,损失L=(h₂−y)²/2,目标y=0。取w=0.5,便有h₁=1、h₂=0.5,损失0.125。w在两处参与计算,因此必须把两处贡献相加。
也可独立核验:h₂=w²x,所以dh₂/dw=2wx=2,乘上dL/dh₂=0.5,仍是1。自动求导会在同一个Parameter对象上累加这些贡献;不是每轮更新一次参数,通常是展开全部轮次、一次backward后再optimizer.step。
如果为了省显存,在h₁处detach,第二轮把h₁当常数,得到梯度0.5×1=0.5,少了第一轮的路径。截断反向传播保存了前向状态,却截掉部分参数依赖,因此一般不再是完整有限展开目标的精确梯度。这是一种需要实验验证的近似,不能描述成“完全不影响训练”。Huginn确实使用尾部有限轮次反传,但这一工程选择的成功不能替代新任务上的比较。
4.能在推理时随便把4轮改成40轮吗?
程序能运行,不代表质量能外推。训练只见4轮时,第20轮的状态分布可能从未被训练过;迭代还可能抹掉有用信息,把原本正确的预测改错。需要在验证集分别画出R=1、2、4、8时的损失、准确率、延迟和显存曲线,并统计“早轮正确、晚轮错误”的比例。循环次数或停止阈值只能由验证集选择,不能看测试集或未来收益挑最优轮数。
还要区分何时停和是否正确。ACT(Adaptive Computation Time,自适应计算时间)学习停止信号;另一些方法看相邻轮输出变化,或看输出分布的熵。熵衡量分布是否分散,例如二分类预测(0.99,0.01)比(0.5,0.5)更确定。然而若真实类别是第二类,前者就是自信地错了。相邻轮相同也可能是稳定地错。Ouro中的熵正则作用于“在哪一轮退出”的概率分布,与直接拿答案熵当正确率不是一回事。
5.KV缓存:权重相同,不代表缓存相同
自回归解码的KV缓存保存历史位置的Key和Value,使新token不必重算全部历史。但第r轮的K=W_KH⁽ʳ⁾,下一轮的K=W_KH⁽ʳ⁺¹⁾;即使W_K相同,只要H改变,K也会变。把所有轮次共用一份缓存,会改变原来的计算语义。不同token若提前退出,还可能缺少对应深度的历史缓存。
可靠实现要明确缓存键是“位置、层、循环编号”中的哪些组合,哪些状态允许覆盖,何时重算,以及误差如何衡量。有些论文专门验证跨轮共享近似;它是方法的一部分,不是无需说明的通用优化。LOTUS可复用不进入循环的固定问题前缀缓存,而循环的潜在位置需要按其定义重新更新。最小教学代码下面直接重算整段输入,不偷偷引入缓存近似。
6.从2018到2026:同一主线,不同监督信号
- Universal Transformers:2018-07首发,ICLR 2019。共享变换沿深度迭代,同时在序列位置之间做注意力;引入逐位置动态停止。它说明循环深度不是2026年才出现的概念。
- Huginn:2025-02。结构分成输入前奏、重复核心、输出尾部,研究在潜在状态上增加测试时计算;训练采用变化的循环深度与截断反传。这里的latent指不必把每一轮状态翻译成文字。
- Ouro / LoopLM:2025-10首发,本文核对2026-10-11的v6。把循环纳入预训练,并学习退出轮数分布;熵正则用于避免深度分配塌缩,再训练门控调节计算分配。
- LoopMTP:2026-08-04预印本。将各轮隐藏表示与不同未来token的嵌入做软对齐,并结合门控聚合;这是潜在表示对齐,不等同于每一轮都做完整词表的多token交叉熵。主干共享,但有每轮特有的归一化设计。
- LOTUS:2026-06首发,核对v2。预留潜在位置,多轮更新,并用已有CoT步骤token并行监督这些位置,另加最终答案监督。因此它依赖步骤标注的训练设计,不能与不需专门CoT数据的方法混为一谈。
这些工作各自在语言、数学或代码基准报告结果。它们没有建立“循环更多→量化预测更好→扣成本收益更高”的证据链。论文里相对不同大小模型的性能,不能改写成同算力、同延迟下普遍胜出,更不能作为金融部署结论。
7.最小PyTorch实现:一个Block确实被复用
代码只演示参数共享、因果掩码和梯度;没有ACT、MTP或论文专门的归一化,也不是完整复现。每个位置只看自己和更早位置;用于历史窗口的最终时点预测时,应另行添加任务输出头。输入形状依次是批量、序列长度、特征维度。
import torch
from torch import nn

torch.manual_seed(7)
class Looped(nn.Module):
    def __init__(self, d=8):
        super().__init__()
        self.block = nn.TransformerEncoderLayer(
            d_model=d, nhead=2, dim_feedforward=16,
            dropout=0.0, batch_first=True, norm_first=True)
        self.norm = nn.LayerNorm(d)

    def forward(self, x, rounds):
        assert rounds >= 1
        mask = torch.triu(torch.ones(
            x.size(1), x.size(1), device=x.device,
            dtype=torch.bool), diagonal=1)
        h = x
        for _ in range(rounds):
            h = self.block(h + x, src_mask=mask)
        return self.norm(h)

model = Looped()
x = torch.randn(2, 5, 8)
ids = tuple(id(p) for p in model.parameters())
count = sum(p.numel() for p in model.parameters())
y1, y4 = model(x, 1), model(x, 4)
assert tuple(id(p) for p in model.parameters()) == ids
assert sum(p.numel() for p in model.parameters()) == count
assert y1.shape == y4.shape == x.shape
model.zero_grad()
y4.square().mean().backward()
assert all(p.grad is not None and torch.isfinite(p.grad).all()
           for p in model.parameters())
print("shared parameters:", count)
8.量化岗位的对照实验与面试回答
如果要尝试历史序列预测,固定输入字段、标签、交易时点与时间切分,以同数据的MLP、GRU和普通Transformer作为基线。循环模型比较1/2/4/8轮;至少分别报告等参数与近似等计算预算两种对照,因为只比较等参数会给多循环模型额外计算。固定回测与交易成本模型,先看预测损失与稳定性,再检查换手、扣成本收益和推理尾延迟。用不同随机种子和多个历史区间检查结论,禁止事后挑唯一赚钱的窗口。
闭卷自测:共享4轮为何只算一份主干参数却做4份前向计算?上面w=0.5的例子detach后为何梯度减半?输出熵低为什么不代表正确?为什么共享W_K仍不能直接共享全部KV?若解释不清这些问题,应先回到计算图,而不是继续背模型名字。
一手资料与核对范围(截至2026-10-24)
本节数值例子、代码和量化对照建议为原创教学;文献观察核对原文方法部分,不据摘要外推。
- Universal Transformers,§2与动态停止(2019-03-05版本)。
- Scaling up Test-Time Compute with Latent Reasoning: A Recurrent Depth Approach,§3、§6(2025-02-17版本)。
- Scaling Latent Reasoning via Looped Language Models,§3与§5.4(2026-10-11版本;HTML不可用,核对PDF)。
- LoopMTP,§3与实验限制(2026-08-04)。
- Bridging the Gap Between Latent and Explicit Reasoning with Looped Transformers,§3(2026-07-13版本)。
把前沿结构变成可检验的量化实验
下列是本教材提出的实验设计,不是上述论文已经证实的量化收益。先固定可见数据、训练时间切分、特征、目标与成本模型,再分别比较稠密基线与MoE、单期与多期监督、固定层数与共享循环。对照应写清是在匹配参数、训练FLOPs、墙钟时间还是在线延迟;这几种预算通常不能同时相同。
例如用过去20天特征预测未来1、5、20天收益,多期标签都合法作为训练答案,但不能进入预测当天的输入。若测试从日期T开始,训练样本t的最长标签到t+20,就应以最长区间检查边界,而不是只给1天目标留空档。三个目标的尺度与噪声不同,直接等权相加可能让某一个目标支配梯度;应报告每个目标的表现和主目标变化。
MoE的路由不能因为被命名为“行业专家”“牛熊专家”就认为真正学到了这些语义。检查每个专家的负载、路由稳定性以及是否只记住资产身份。跨资产注意力还要核对同一决策时刻各资产的数据是否确实已发布。稀疏算量变少但路由通信变多,可能让实时尾延迟变差。
Looped模型应画循环次数1、2、4、8下的留出误差、置信度与实际延迟曲线,并记录是否有更多循环反而退化的样本。不能只展示挑出的最佳循环数,也不能以低熵直接认定预测正确。若多轮思考只让模型更自信地追随过时规律,需要重查漂移与停止策略,而不是无限加循环。
独立自测:MoE模型的训练损失更低、多期预测的平均误差更低、循环模型的回答更自信,哪一个单独足以支持上线?都不够。仍须查主任务的留出表现、选择偏差、数据边界、延迟、成本与失败条件。
量化应用:先画时间线,再谈模型好坏
★ 核心必会。模型应接到明确的预测时刻。例如周二收盘后,用周一至周二的数据预测周三收盘收益。周三才发布的修订财务数据,即便字段名写周二,也不能使用。“数据所属日期”和“首次可见时间”是两个不同字段。
切分一个有重叠标签的小例子
一条标签若是未来三天累计收益,则时点t的标签用到t+1、t+2、t+3。假设验证预测从第10天开始。第8天训练样本的标签覆盖9—11,与验证期交叉;第9天的标签覆盖10—12,也交叉,不能当作已完全隔离的历史训练信息。最保守的边界要求训练标签末端严格早于验证预测起点:\(t+3<10\),故只保留t≤6。第7天是否可保留取决于第10天的准确决策时刻和标签何时已知,不能只凭日期猜。
特征标准化的均值、方差必须只在训练期估计;验证和测试沿用冻结参数。每个滚动窗口可重估,但只能用当时已知资料。交易日之间样本相关,不能把窗口数量直接当独立样本数,也不能把一百次随机种子当一百份独立市场历史。
因果掩码解决哪一层泄漏
若每个位置都预测其下一步,位置i只能注意到j≤i,须屏蔽右上角未来位置。若整段历史都是截止当前已知输入,只在末端做一个预测,历史内部双向注意力本身不构成使用未来市场数据。但为了通用逐位置训练,本书代码采用因果掩码。模型里有causal mask,仍挡不住输入字段来自未来、全样本归一化或标签重叠。
可证伪的基线、消融与最终选择
先比较“始终预测0”、简单线性模型、树模型与小型RNN,再比较Transformer,使用相同可用信息和时间留出。若Transformer新增特征、窗口和搜索预算同时变化,无法把收益归因于架构。消融可依次去掉位置编码、缩短历史、关闭新增特征,并记录哪些变化损害留出表现。若效果只在挑中的一个区间出现,应重查漂移与搜索偏差。
评估至少分三层:预测误差/概率质量;按明确仓位规则得到的毛收益和换手;扣成本、融资和实际成交约束后的结果。IC指横截面或时序上的预测与后续收益相关性,必须写清计算对象、窗口和聚合方式,不是任何高IC都能交易。部署还要测目标硬件上的延迟、吞吐和内存,不能用训练速度代替推理速度。
自测:把同一股票相邻日期随机分进训练和测试,即便没有重复行,安全吗?答案:不保证。历史窗口和未来标签可能重叠,市场状态也相关;应按决策时间和标签区间隔离。
闭卷知识盘点:能否解释、计算并排错
- 画出B×L×F输入、RNN状态、QKV和预测头的形状;说明每个矩阵在做什么。
- 手算两步RNN,解释梯度为什么会成为多个Jacobian(局部导数矩阵)的乘积。
- 说清LSTM的遗忘门、输入门、输出门分别控制什么;细胞状态通路为什么只是缓解而非彻底消除梯度问题。
- 计算两token注意力权重;说明softmax在哪个轴上、sqrt(d_k)为何出现。
- 画pre-LN的完整残差块,说明去掉位置编码后为什么无法一般地区分序列顺序。
- 手算Adam最初两步;解释偏差校正、二阶矩和方差的区别。
- 比较SGD下L2与weight decay的等价条件,再说明Adam下为何不同。
- 列出梯度累积、AMP、裁剪、优化器、调度器和清零的次序,解释最后一个不足累积长度的批次。
- 解释训练并行、逐token推理、KV cache与金融滑窗推理为什么不是同一种成本问题。
- 给一个“有因果掩码却仍泄漏”的反例,再设计能证伪模型优势的对照实验。
- 四个专家选两个,加入路由偏置后选中者改变时,输出权重是否也应该使用偏置?解释MoE不同实现的约定。
- 画出两个未来预测头的标签移位与尾部mask,再说明为何不能直接把多头结果拼成一段自回归生成。
- 同一个block循环四次,独立参数、激活、梯度与延迟分别怎样变化?举一个更多循环反而发散的例子。
验收方式:架构与优化各用两分钟口述;任选数值例遮住答案重算;再改变一个输入形状或时间边界。如果只能背原例,回到对应小节补第一步。这里不提供未经测试的面试通过率承诺。
资料与证据边界
本教材独立编写例题和复习优先级,不声称统计了出题频率,不保证某种架构优于基线或产生盈利。模型公式与接口依据原论文和官方文档核对;代码在CPU执行验证,AMP的GPU执行与实际市场数据表现需另行测试。
Jane Street官方机器学习介绍 · Vaswani 等:Attention Is All You Need · Su 等:RoFormer · PyTorch LSTM · PyTorch GRU · PyTorch TransformerEncoderLayer · Transformer · Kingma 与 Ba:Adam 原论文 · PyTorch Adam · PyTorch SGD · PyTorch AdamW · PyTorch AMP 示例
FlashAttention原论文